DeepSeek V4.1 Flash : la nouvelle révolution puissance-prix de l’IA chinoise
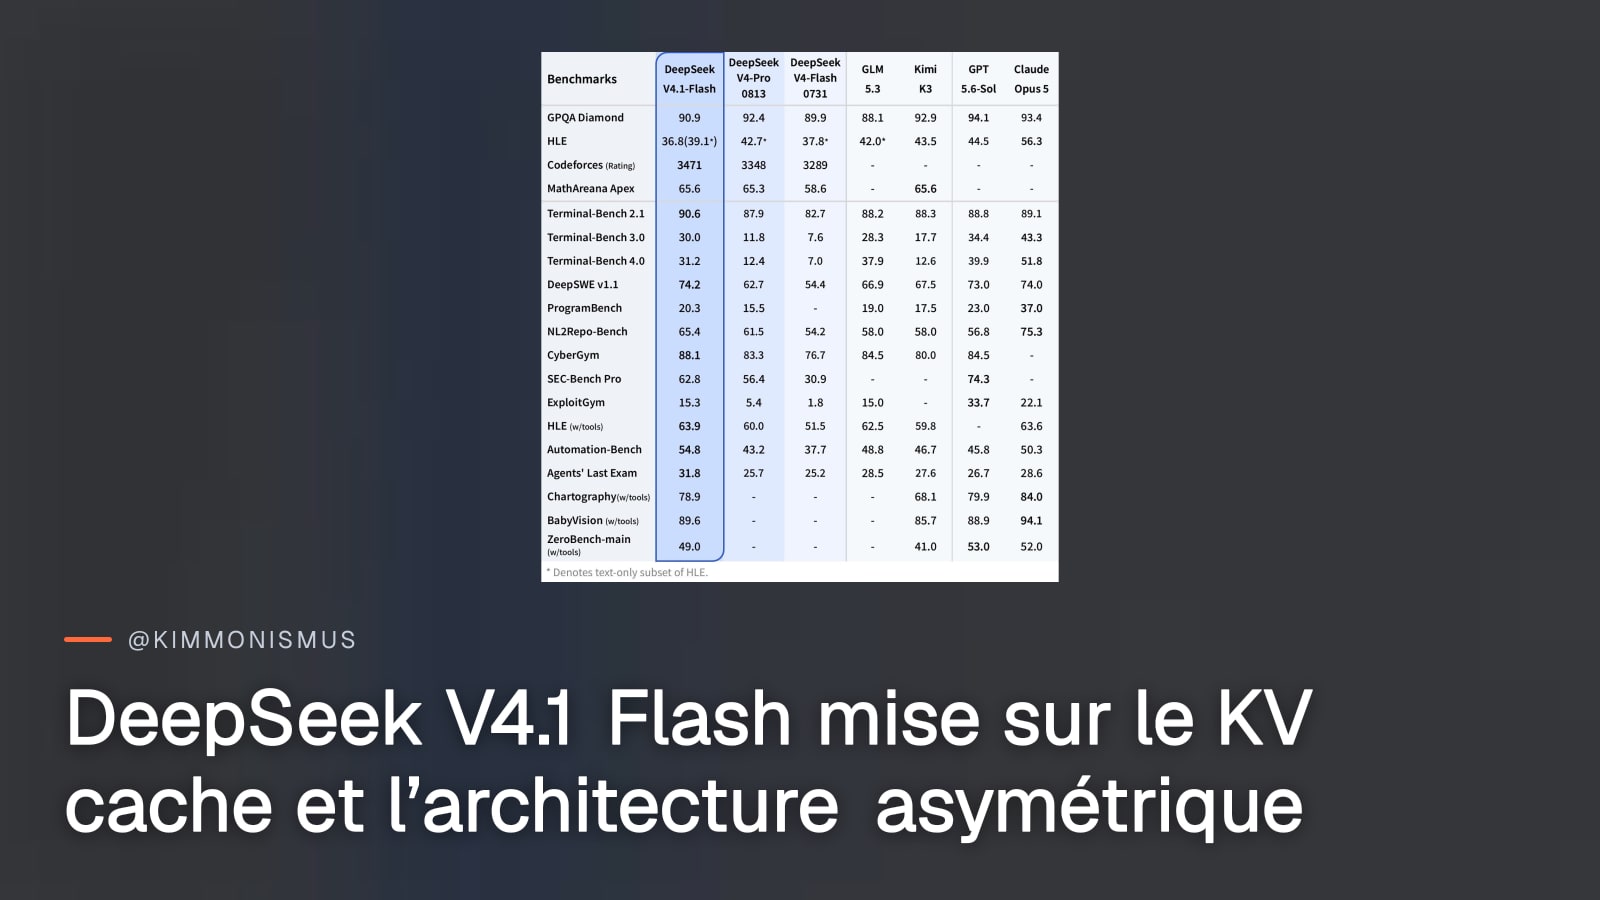
@kimmonismus présente DeepSeek V4.1 Flash comme un saut rapide après la version de juillet, grâce à une architecture Causal Encoder Decoder, 552 milliards de paramètres MoE et un KV cache nettement réduit. Le thread officiel de @deepseek_ai confirme les chiffres centraux, annonce le retrait progressif de V4 Pro et insiste sur les coûts de cache, les prix API et le support multimodal natif. Dans les réponses, l’enthousiasme porte surtout sur l’inférence locale et le rythme des sorties, tandis que plusieurs lecteurs contestent l’idée qu’un modèle Flash soit devenu un modèle frontière, en pointant ses résultats contrastés à Terminal Bench. La promesse d’auto hébergement est donc réelle pour des déploiements équipés, mais l’annonce officielle évoque aussi explicitement des installations de 2 000 GPU avec stockage.
Must cover:
- Le thread officiel de @deepseek_ai décrit V4.1 Flash comme le plus petit modèle d’une nouvelle famille, avec compréhensi
- DeepSeek annonce un MoE de 552 milliards de paramètres, dont 8 milliards actifs à l’entrée et 16 milliards à la générati
- Le chiffre opérationnel majeur est le KV cache annoncé à un quart de la HBM et un huitième du stockage SSD de la générat
- V4 Flash et V4 Flash Vision Exp sont retirés, et les requêtes V4 Pro doivent basculer temporairement vers V4.1 Flash à p
- L’affirmation de supériorité sur V4 Pro repose, selon @deepseek_ai, sur des tests de plusieurs parties, mais le thread n
- Les critiques sur Terminal Bench nuancent le récit de domination globale, @Greg_GL_87 cite 31,2 pour V4.1 Flash contre 3
- Le post externe mentionné par l’utilisateur, @ns123abc, avance environ 86 fois moins cher par million de tokens et 420 à