LLM Failover : comment construire une app IA qui survit aux pannes de fournisseurs
Rédigé par Gab
Sommaire
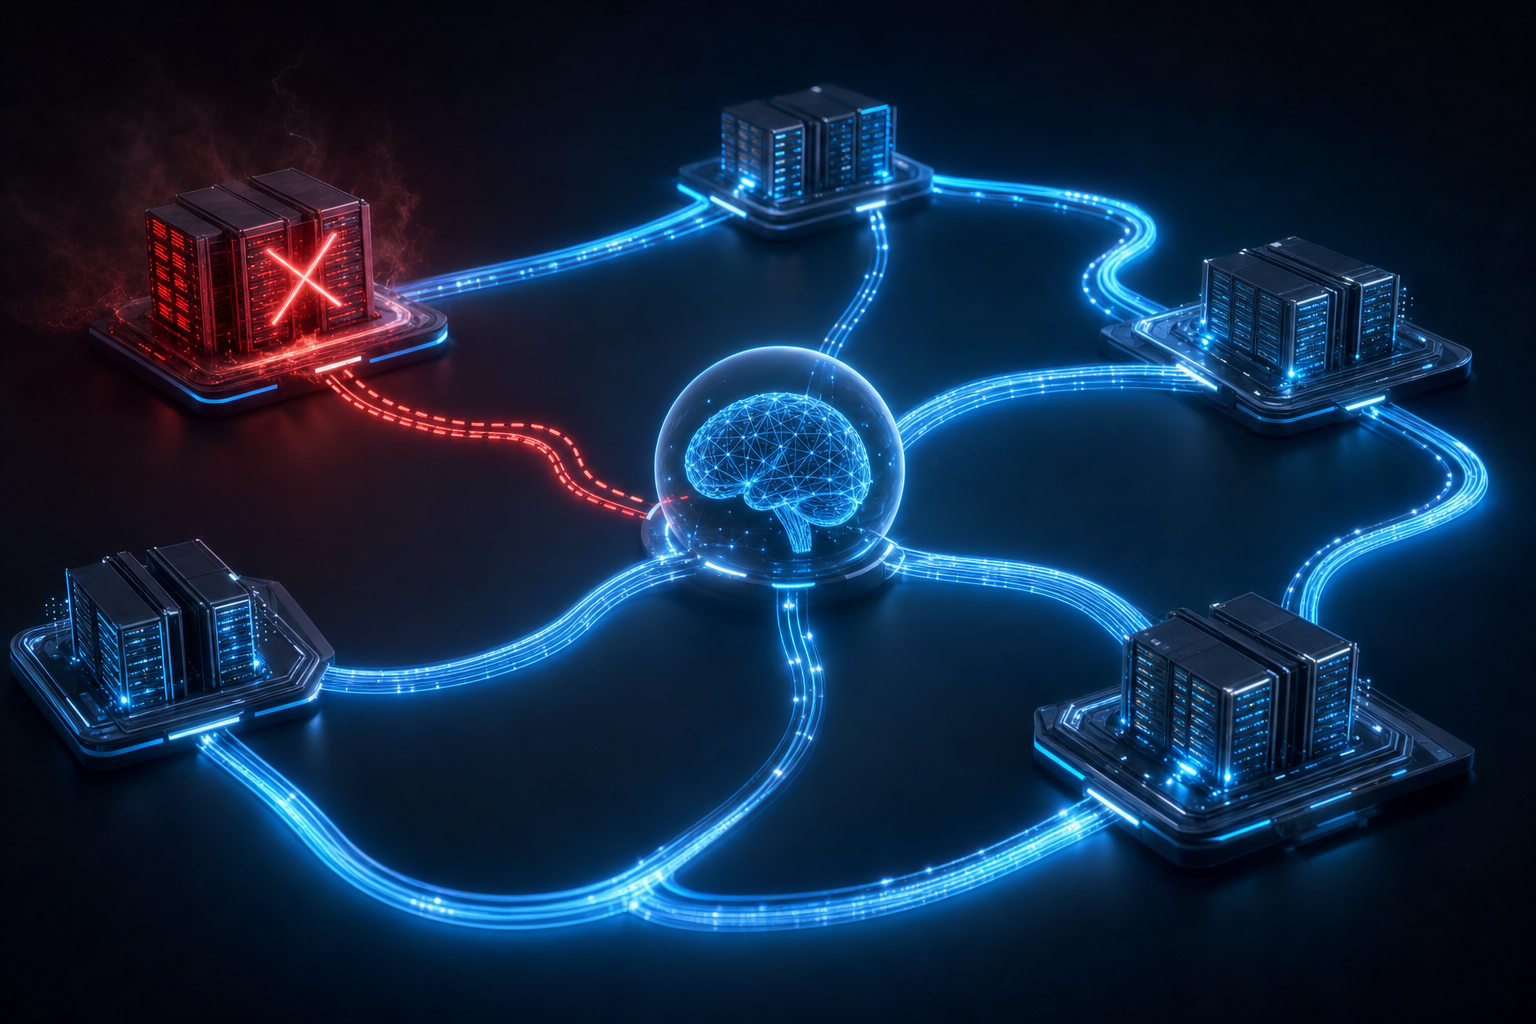
Une application IA qui dépend d’un seul endpoint LLM possède un point de défaillance évident. Rate limit, panne fournisseur, saturation, erreur réseau ou indisponibilité d’un modèle peuvent suffire à transformer une fonctionnalité centrale en erreur 500.
Le bon design n’est pas de relancer la même requête dix fois. Il faut distinguer retry, provider failover, model fallback et graceful degradation.
Les quatre niveaux de résilience
1. Retry
Vous réessayez le même appel lorsque l’erreur est probablement transitoire.
2. Provider failover
Vous gardez le même modèle logique mais utilisez un autre fournisseur d’inférence.
3. Model fallback
Vous passez à un autre modèle lorsque le premier n’est plus disponible ou ne peut pas traiter la requête.
4. Graceful degradation
Vous acceptez une qualité ou une fonctionnalité réduite plutôt que de faire échouer tout le produit.
Une architecture robuste utilise ces mécanismes dans cet ordre et avec un budget de latence explicite.
Provider failover et model fallback ne sont pas la même chose
OpenRouter documente clairement ces deux couches.
Le provider failover garde le même modèle et change l’infrastructure qui le sert. Chez OpenRouter, ce mécanisme est actif par défaut lorsque plusieurs providers sont éligibles.
Le model fallback change de modèle. Il est opt-in et se configure avec une liste ordonnée de modèles alternatifs.
Cette distinction est importante pour la qualité du produit. Changer de provider est souvent invisible pour l’utilisateur. Changer de modèle peut modifier le style, les outils supportés, la latence ou le comportement.
Ne retryez pas toutes les erreurs
AWS recommande de ne réessayer que les erreurs susceptibles de réussir lors d’une nouvelle tentative, comme certains timeouts, erreurs réseau temporaires, throttling et erreurs serveur transitoires.
Un 401 causé par un credential invalide ne sera pas réparé par cinq retries. Une requête invalide non plus.
Créez donc une classification interne :
| Catégorie | Action |
|---|---|
| Throttling / 429 | Backoff puis retry ou failover |
| Timeout réseau | Retry limité, puis failover |
| 5xx temporaire | Retry limité, puis failover |
| Auth / permission | Échec immédiat et alerte |
| Input invalide | Échec immédiat |
| Modèle indisponible | Provider ou model fallback |
| Contexte trop long | Modèle fallback ou réduction du contexte |
Exponential backoff et jitter
Relancer immédiatement une requête après un 429 peut aggraver la saturation.
AWS recommande l’exponential backoff avec jitter et un nombre maximal de tentatives.
Le backoff augmente progressivement l’attente. Le jitter ajoute une petite part d’aléatoire afin d’éviter que des milliers de clients ayant échoué au même moment ne réessaient tous ensemble.
La règle pratique :
- respecter
Retry-Afterlorsqu’il existe ; - limiter le nombre de retries ;
- ajouter du jitter ;
- respecter le budget de latence de l’utilisateur ;
- ne pas retryer à plusieurs couches sans le savoir.
Le dernier point est important. Si votre SDK retrye trois fois et que votre service retrye lui aussi trois fois, une seule requête utilisateur peut provoquer une tempête d’appels.
Un budget de tentatives, pas une boucle infinie
Pensez en budget total.
Exemple conceptuel :
Tentative 1 : provider principal
Tentative 2 : même modèle, autre provider
Tentative 3 : modèle fallback rapide
Puis arrêt
Le nombre exact dépend de votre UX. Un chatbot interactif a un budget beaucoup plus court qu’un traitement batch nocturne.
Le système doit échouer proprement avant que l’utilisateur ait abandonné la page.
Le circuit breaker
Lorsqu’un fournisseur échoue de manière répétée, continuer à l’appeler gaspille du temps et de la capacité.
Un circuit breaker retire temporairement un backend du chemin principal après un seuil d’échecs, puis effectue une tentative de récupération après une période définie.
Ce pattern évite de transformer une panne fournisseur en panne de votre propre infrastructure.
Il est particulièrement utile lorsque vous gérez vous-même plusieurs APIs directes.
Pourquoi OpenRouter simplifie fortement le problème
OpenRouter gère automatiquement le failover entre providers servant un même modèle. La plateforme permet de contrôler les candidats avec order, only, ignore et allow_fallbacks.
Pour changer de modèle, une liste de fallbacks peut être fournie. La documentation indique notamment des déclenchements possibles en cas de downtime, rate limiting, erreurs de longueur de contexte et certains refus de modération.
Cette couche réduit beaucoup de code de résilience, mais elle ne supprime pas le besoin d’une stratégie au niveau de votre application.
Un gateway reste lui-même une dépendance. Votre produit doit savoir gérer un échec final.
L’architecture multi-provider recommandée
Évitez que le frontend connaisse le fournisseur réel.
Frontend
  -> votre API
  -> LLM Gateway interne
       -> OpenRouter
       -> API directe A
       -> API directe B
  -> métriques
  -> réponse normalisée
Votre gateway interne choisit une politique, pas forcément un modèle hardcodé.
Exemples :
policy = fast_chat
policy = premium_reasoning
policy = cheap_batch
policy = private_data
Chaque policy peut définir modèle principal, providers autorisés, timeout, budget et fallback.
Normalisez les erreurs
Ne laissez pas le reste de votre produit dépendre des messages spécifiques d’OpenAI, Anthropic, Groq ou d’un autre backend.
Utilisez vos propres catégories :
RATE_LIMITEDTIMEOUTPROVIDER_UNAVAILABLEINVALID_REQUESTAUTH_ERRORPOLICY_REJECTEDCONTEXT_TOO_LARGE
Votre stratégie de résilience devient alors indépendante du fournisseur.
Attention aux fallbacks qui changent le comportement
Un modèle fallback n’est pas toujours interchangeable.
Vérifiez au minimum :
- tool calling ;
- structured outputs ;
- taille de contexte ;
- multimodalité ;
- schéma JSON ;
- comportement de sécurité ;
- latence ;
- coût.
Un fallback incapable d’utiliser les tools de votre agent peut produire une réponse textuelle correcte tout en cassant le workflow.
Testez donc la chaîne complète, pas seulement un prompt simple.
Pensez à la confidentialité
Un failover peut faire partir une requête vers un provider que votre politique de données n’autorise pas.
La résilience ne doit pas contourner la compliance.
Chez OpenRouter, vous pouvez restreindre les providers et imposer des contraintes de politique de données. Dans votre propre gateway, gardez la même logique : un fallback doit appartenir au même niveau de confiance que le backend principal.
Graceful degradation
Parfois, la meilleure réponse à une panne n’est pas un autre LLM.
Votre produit peut :
- servir une réponse mise en cache ;
- désactiver temporairement une fonctionnalité non essentielle ;
- retourner une version plus simple du résultat ;
- mettre un job en queue ;
- demander à l’utilisateur de réessayer plus tard.
Une expérience dégradée mais cohérente est souvent meilleure qu’une série de fallbacks lents qui finit par échouer.
Mesurez ce qui se passe réellement
Suivez au minimum :
- taux de succès par provider ;
- taux de fallback ;
- causes des fallbacks ;
- latence p50, p95 et p99 ;
- coût par requête réussie ;
- fréquence des 429 ;
- timeouts ;
- modèle réellement utilisé ;
- nombre moyen de tentatives.
Si 30 % de vos requêtes utilisent le fallback, ce n’est plus un fallback. C’est un changement d’architecture que vos métriques doivent rendre visible.
Testez les pannes volontairement
Une stratégie de failover jamais testée n’est pas une stratégie.
Simulez :
- un provider qui retourne 429 ;
- un timeout ;
- un 5xx ;
- un modèle indisponible ;
- une réponse trop lente ;
- un fallback incompatible avec vos tools.
Vérifiez ensuite que le coût, la latence et l’expérience utilisateur restent acceptables.
Verdict
Pour la majorité des équipes, OpenRouter est le moyen le plus simple d’obtenir un provider failover solide sans construire toute la plomberie soi-même.
Mais une application réellement résiliente ajoute sa propre couche : classification des erreurs, budget de retry, backoff avec jitter, timeouts, métriques et graceful degradation.
Le but n’est pas de garantir qu’aucun fournisseur ne tombe. Le but est de faire en sorte que la panne d’un fournisseur ne devienne pas automatiquement la panne de votre produit.
Voir aussi OpenRouter vs API directes et notre guide des meilleurs fournisseurs d’API LLM.