Best AI API Providers : les meilleures plateformes pour construire une app IA
Rédigé par Gab
Sommaire
Choisir une API IA ne consiste plus seulement à choisir un modèle. Le vrai choix porte sur la couche qui relie votre produit aux modèles : routage, disponibilité, clés, coûts, observabilité et capacité à changer de backend sans réécrire l’application.
Notre verdict est simple. OpenRouter est le meilleur choix généraliste pour les LLM. fal est notre référence pour les workloads image et vidéo longs. Replicate reste excellent pour explorer rapidement un grand catalogue. Fireworks AI et Together AI sont très solides pour industrialiser des modèles ouverts. GroqCloud est à tester lorsque la latence est critique. Cloudflare est particulièrement intéressant pour une stack edge. Kie.ai est une option convaincante pour les workflows média sensibles au coût.
Le classement en bref
| Plateforme | Meilleur usage | Force durable |
|---|---|---|
| OpenRouter | LLM multi-modèles | Routage, fallbacks, API unifiée, BYOK |
| fal | Image et vidéo | Queue persistante, webhooks, retries |
| Replicate | Exploration | Catalogue large, modèles officiels stables |
| Fireworks AI | Modèles ouverts en production | Serverless, dédié, autoscaling, training |
| Together AI | Stack open models | Inference, fine-tuning, endpoints dédiés |
| GroqCloud | Latence | Inference rapide, projets et quotas |
| Cloudflare | Edge et serverless | Workers AI, Gateway, réseau global |
| Kie.ai | Média et budget | Async, limites par clé, agrégation |
1. OpenRouter, notre choix n°1 pour les LLM
OpenRouter ne se contente pas de proposer beaucoup de modèles. Sa vraie valeur est de séparer le modèle demandé du fournisseur qui sert réellement la requête.
La plateforme documente un routage par prix, débit ou latence, des fallbacks entre providers, des listes de providers autorisés ou exclus, des politiques de données, le Zero Data Retention lorsque disponible et le BYOK pour utiliser ses propres clés fournisseur.
OpenRouter permet aussi de gérer des clés programmatiquement, avec limites de crédit et suivi d’usage. Pour une équipe SaaS, cela réduit fortement le coût d’un changement d’infrastructure.
Nous détaillons cette architecture dans notre guide des meilleurs fournisseurs d’API LLM.
2. fal, le meilleur choix généraliste pour la vidéo et l’image
Une génération vidéo n’est pas une simple requête HTTP. Elle peut rester en attente, durer plusieurs minutes, échouer, être relancée et produire un fichier temporaire.
fal est particulièrement convaincant parce que son infrastructure est pensée autour de ce cycle. Sa documentation recommande la queue pour les workloads longs et permet de récupérer le résultat par polling ou webhook. Les webhooks peuvent être vérifiés cryptographiquement, ce qui est important dès qu’un callback déclenche une livraison ou une facturation.
Pour la vidéo, nous privilégions donc la qualité de la queue, des retries et des callbacks avant la popularité du modèle du moment. Voir notre comparatif des meilleures API vidéo IA.
3. Replicate, excellent pour explorer
Replicate reste l’une des plateformes les plus simples pour tester rapidement de nombreux modèles.
Son avantage le plus durable est la notion de modèles officiels. Replicate indique maintenir plus de 100 modèles officiels, toujours disponibles, avec une API stable et une tarification prévisible selon le type de sortie.
La plateforme propose également des prédictions synchrones ou asynchrones et des webhooks. Il faut toutefois connaître une contrainte importante : pour les prédictions créées par API, les inputs, outputs, fichiers et logs sont supprimés après une heure par défaut. Les résultats utiles doivent donc être copiés vers votre propre stockage.
4. Fireworks AI, très fort pour industrialiser les modèles ouverts
Fireworks propose une trajectoire logique pour une équipe ML : commencer en serverless, puis évoluer vers des déploiements dédiés lorsque les besoins de performance ou de contrôle augmentent.
La plateforme expose des APIs compatibles OpenAI pour les modèles texte, des déploiements GPU dédiés, de l’autoscaling, des options d’optimisation et du fine-tuning.
C’est un très bon choix lorsque votre objectif est moins de changer constamment de fournisseur que d’optimiser sérieusement l’exécution de modèles ouverts.
5. Together AI, une plateforme cohérente autour de l’open source
Together AI couvre l’inférence, le fine-tuning et les endpoints dédiés avec une forte compatibilité avec l’écosystème OpenAI.
Together et Fireworks se ressemblent davantage qu’ils ne ressemblent à OpenRouter. Ce sont des plateformes d’inférence. OpenRouter est d’abord une couche de routage multi-fournisseurs.
Pour une équipe centrée sur les modèles ouverts, Together mérite donc une évaluation sur le workload réel, notamment sur la latence, le throughput et la trajectoire vers du dédié.
6. GroqCloud, à tester lorsque la vitesse est critique
GroqCloud se distingue par son positionnement sur la vitesse d’inférence et une API largement compatible avec OpenAI.
Les projets Groq isolent les clés, les limites, les données d’usage, les coûts et les logs. La documentation recommande explicitement des projets séparés pour développement, staging et production.
Groq expose aussi les informations de rate limiting dans les headers HTTP et retourne un 429 lorsque les limites sont dépassées. Cela rend plus simple l’implémentation d’un backoff propre.
7. Cloudflare Workers AI et AI Gateway, très fort à l’edge
Workers AI exécute des modèles sur des GPUs serverless du réseau Cloudflare. Pour une application déjà construite avec Workers, Pages, KV ou Durable Objects, l’intégration est naturelle.
AI Gateway apporte une couche supplémentaire de contrôle devant plusieurs fournisseurs. Cloudflare propose également une facturation unifiée pour certains providers externes via des crédits prépayés.
Ce n’est pas la solution la plus neutre si votre priorité absolue est l’indépendance d’infrastructure, mais c’est une combinaison très puissante pour une stack edge.
8. Kie.ai, un bon compromis coût et couverture média
Kie.ai agrège de nombreux workloads image, vidéo, audio et conversationnels.
Sa documentation précise que les tâches de génération sont asynchrones, qu’un task_id est retourné, puis que le résultat peut être récupéré par callback ou polling. Kie propose aussi des limites horaires, journalières et globales par clé, une whitelist IP et des logs de consommation.
Les médias générés sont actuellement conservés 14 jours. Kie reconnaît également que sa stabilité globale peut être légèrement inférieure aux fournisseurs officiels, en échange de tarifs agressifs.
C’est un compromis acceptable pour certains produits, à condition de le concevoir explicitement avec stockage propre et fallback lorsque le workflow est critique.
Les critères qui comptent vraiment
Abstraction. Pouvez-vous changer de backend sans modifier toute l’application ?
Disponibilité. Existe-t-il des fallbacks, plusieurs providers ou plusieurs régions ?
Gestion des erreurs. Les 429, timeouts et erreurs de capacité sont-ils documentés ?
Sécurité. Pouvez-vous isoler, limiter, suivre et révoquer les clés ?
Observabilité. Latence, coût, tokens, erreurs et provider réel sont-ils visibles ?
Politique de données. Pouvez-vous contrôler rétention, entraînement et région de traitement ?
Asynchrone. Pour l’image et la vidéo, avez-vous queue, polling, webhooks et retries ?
Stockage. Les fichiers de sortie sont-ils permanents ou devez-vous les copier immédiatement ?
L’architecture que nous recommandons
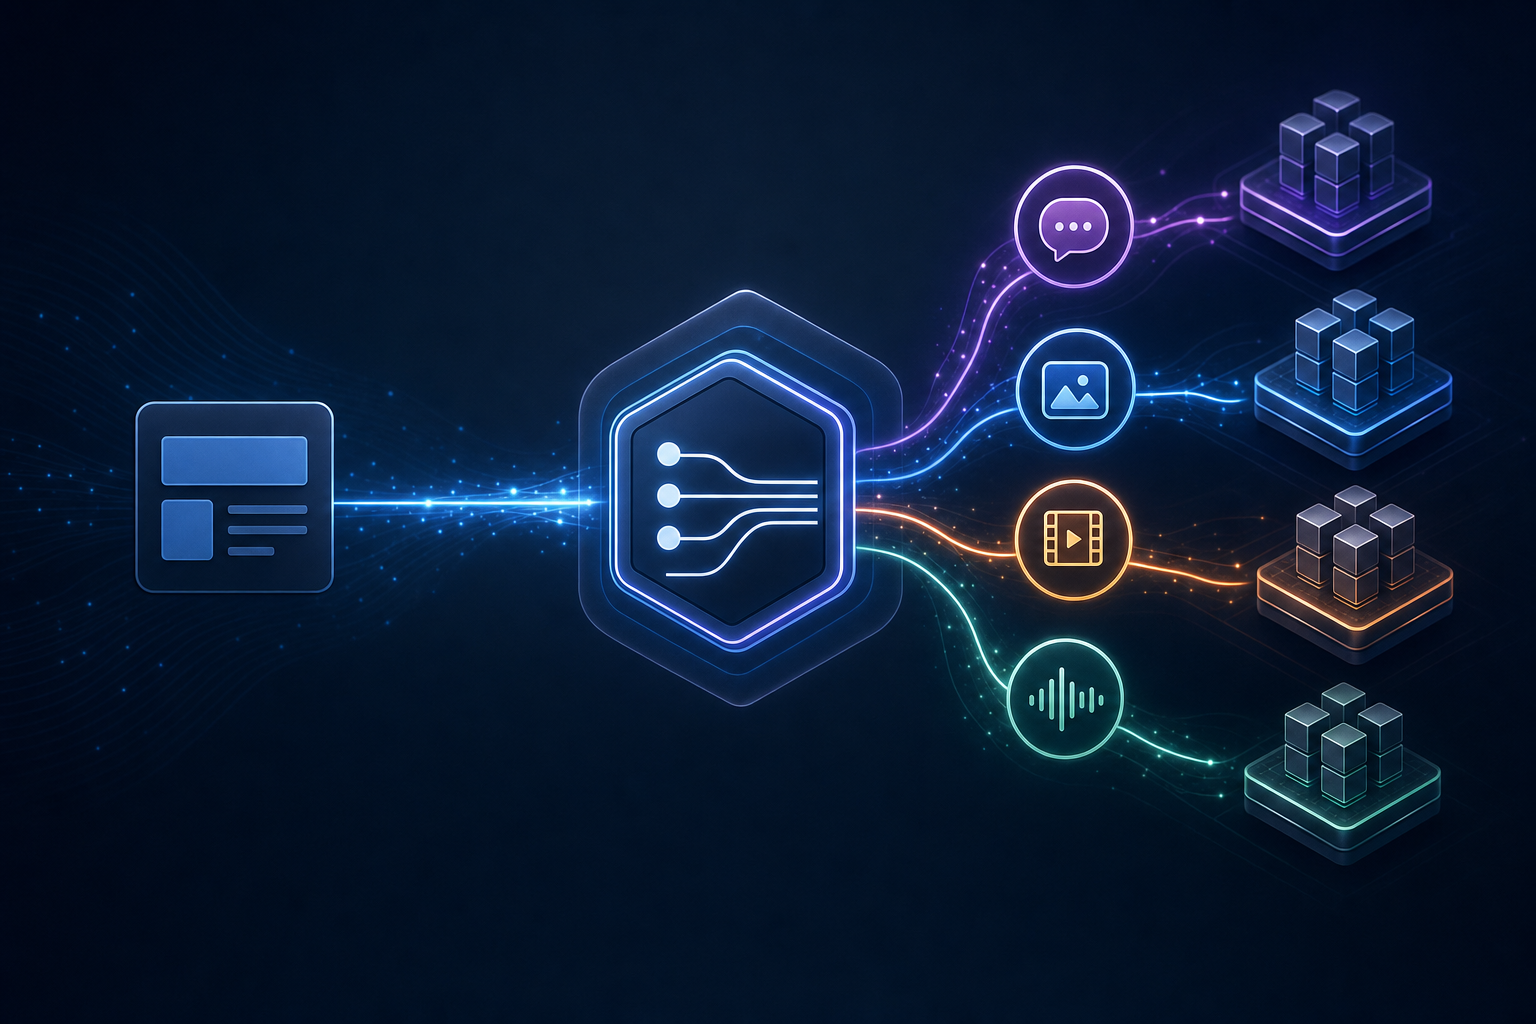
Votre frontend ne devrait pas connaître directement tous les providers. Il appelle votre backend, et votre backend passe par une couche interne qui décide du fournisseur.
Application
  -> couche AI interne
  -> router ou provider
  -> métriques, coûts, erreurs
  -> réponse
Pour les jobs longs :
Frontend
  -> votre API
  -> job interne
  -> provider
  -> webhook ou polling
  -> votre stockage
  -> job terminé
Cette séparation est plus importante que le fournisseur choisi aujourd’hui.
Verdict
Pour une nouvelle application LLM, nous commencerions par OpenRouter. Pour la génération média, fal est notre choix généraliste. Replicate est excellent pour expérimenter, Fireworks et Together pour approfondir une stack open models, Groq pour la vitesse, Cloudflare pour l’edge et Kie pour une approche média très sensible au coût.
Le meilleur AI API provider n’est pas celui qui gagne le benchmark de la semaine. C’est celui qui vous permet de remplacer le gagnant du benchmark suivant sans réécrire votre produit.