研究者がAnthropicを退職、超知能の差し迫る危険に警鐘
執筆 Gab
目次
Anthropicの超知能リスクをめぐる辞任として注目された、X上で@hilbertspaessのハンドルネームで知られる研究者、Jacob Coxonの辞任は、単なる退職発表にとどまるものではない。彼は7件のポストからなるスレッドで、OpenAIとAnthropicにおいて3年間にわたりpretrainingの研究に携わった後、Anthropicを退職したと述べている。そして、両社が必要な安全保証を確保しないまま、自己改善型の超知能の実現に向けて突き進んでいると非難している。
彼の告発には2つの側面がある。一方では、今後登場するシステムは、現実世界で実際の権力を獲得できるほど強力になるという。もう一方では、その開発に携わる一部の人々が、10年以内にAIが存亡リスクをもたらすと、すでに内心では考えているという。それにもかかわらず、同じ組織が開発を加速し続けているのは、危険性を十分に自覚していないためか、あるいは何としても先行する必要があると判断しているためだという。
このスレッドは4,570万回の表示を記録し、35万5,800件の「いいね」、6万5,000件のリポスト、7,900件の返信、1万5,700件の引用を集めた。しかし、内容のある主な反応は、彼の内部証言そのものというよりも、内心の懸念から技術的に起こり得る大惨事、さらには政治的に実現可能な解決策へと論を進める部分に疑問を呈している。
議論の発端となったポストは以下のとおりだ。
Jacob Coxonのスレッド、7つの連続した論点
1. pretrainingの中枢で3年間働いた末の辞任
最初のメッセージで、Jacob CoxonはAnthropicを辞任したと発表している。過去3年間、まずOpenAI、その後Anthropicでpretrainingに携わってきたと説明している。
pretrainingとは、モデルが極めて大規模なデータセットから学習する段階である。したがって、広報や公共政策といった周辺的な職務ではなく、フロンティアモデルの能力向上に直接関わる役割だ。
Coxonは、OpenAIもAnthropicも「責任ある行動を取っていない」と主張する。彼によれば、両社は自己改善能力を持つ超知能の実現に向けて真っすぐ突き進み、すべての人の命を賭けにさらしている。
**彼の出発点は、業界外部からの批判ではなく、内部からの証言である。**それだけで彼が訴える危険性が証明されるわけではないが、このメッセージが大きな影響を持つ理由にはなる。彼が語っているのは、自動化に関する抽象的な懸念ではない。AI開発競争の力学を間近で観察してきたと主張しているのだ。
2. 間もなく人間を超え、現実世界で行動できるシステム
2つ目のポストで、Coxonは開発中の技術の力を過小評価しないよう訴えている。彼が描くのは、間もなく人間を超える能力を持ち、あらゆるシステムに侵入し、分野全体を一夜にして変革し、現実の権力や資源を獲得できるようになるシステムだ。
彼は2つの点を強調している。
- ハッキング、科学、計画能力の分野で確認されている進歩;
- こうした進歩に減速の兆しが見られないこと。
したがって、彼の推論は、単に質問への回答能力が向上するAIだけを前提としたものではない。彼が想定しているのは、より汎用的なシステムであり、急速な進歩を生み出し、インフラや組織、物的資源に介入し得るものだ。
Coxonの主張は、高度な知能が単なる対話型アシスタントの枠をはるかに超え、実効的な権力へと転化し得るというものだ。
まさにこの表現に対して、物理的な制約を指摘する人々が異議を唱えている。彼らにとって、より高い知能を持つことが、現実世界で物体を自動的に製造、移動、制御、あるいは試験できることを意味するわけではない。
3. AIを構築する人々が内心で表明している恐怖
3つ目のポストでは、議論が一段踏み込む。Coxonは、AIを構築している人々が、それによって10年以内に人類全員が殺される可能性があると本気で考えている、と書いている。彼は、それがマーケティング上の主張ではないと強調する。
彼によれば、多くの幹部やシニア研究者は、理性的に見られるため、公の場ではより慎重な言い回しを用いているという。しかし、内輪では、同じ人々が恐怖を口にしていると彼は主張する。さらに、これほどの危険を伴う人間の活動はほかに存在しないと付け加えている。
スレッドのこの部分は重要だ。OpenAIとAnthropicの全従業員が同じ確信を共有している、と述べているわけではないからだ。Coxonが指しているのは、フロンティアモデルを構築・指揮する人々のうちの一部であり、その確信の度合いもさまざまだという。
彼の告発の核心は、一部の関係者が内心で抱く恐怖と、公然と開発競争を続ける姿勢との間にある矛盾だ。
しかし、コメント欄では、この証言を確定した事実として受け止めてはいない。そこで特に強調されているのは、たとえ経営陣が大惨事を懸念していたとしても、その懸念だけでは、それがどのように起こるのかまでは説明できないという点である。
4. なぜOpenAIとAnthropicで仕事を続けるのか?
4番目の投稿では、最も明白な反論に答えている。関係者が本当に危険を信じているのなら、なぜ仕事を続けるのか?
Coxonは、2つの異なる見立てを示している。
-
OpenAIでは、多くの人が文明規模の問題を深く内面化していないという。リスクは議論されているものの、日々の意思決定に十分に反映されない抽象的な概念にとどまっている。
-
一方、Anthropicでは、その問題は十分に理解されているという。したがって、問題は無知ではない。むしろCoxonは、同社のメンバーが、ほかの誰も責任ある行動を取らないと考えているため、自社が最初に到達するための競争から抜け出せなくなっていると主張する。この論理に従えば、リスクがあっても勝たなければならないということになる。
この区別は重要である。これにより、彼の主張を、研究所が単に無謀または無自覚であるという考えに矮小化せずに済む。OpenAIについては、問題を内面化できていないと述べている。Anthropicについては、リスクを明確に理解しながらも競争を受け入れる論理を描いている。
このスレッドは、AI競争をAI安全性やalignmentの問題であると同時に、ガバナンスと戦略の問題として提示している。
5. 「エンドゲーム」は、民間企業に委ねるべきではない賭け
5番目の投稿で、Coxonは、この競争を受け入れて「エンドゲーム」に突入することを、傲慢な賭けだと評している。そのような決定は、民間企業のSlack上で下されるべきではないと主張する。
この一文によって、議論の焦点は移る。Coxonが求めているのは、評価の強化や技術的な安全策、あるいはalignment研究者の増員だけではない。人類にとって不可逆的になり得ると彼が考える進路について、民間組織が決定することの正当性そのものに異議を唱えている。
さらに、alignmentを加速させようとすること、言い換えれば、高度なAIを人間の目標と持続的に整合させるという問題を猛スピードで解決しようとすることは、ほかにより良い進路が存在しないという並外れた確信を必要とする、と付け加えている。
彼の異議は、少数の民間組織が超知能へのスプリントを決定する権利そのものに向けられている。
また、これは実務面で最も具体性に欠ける点でもある。Coxonは、より良い進路が存在する可能性を指摘するものの、それがどのようなものか、また誰がそれを選ぶべきかについては詳述していない。
6. 米国の研究所間の連携、その後にあり得る一時的な禁止措置
6番目の投稿で、Coxonは連携の可能性について楽観的な見方を示している。Hugging Faceへの攻撃のような警戒すべき兆候により、米国の研究所間で開発ペースに関する合意を結ぶことが、以前よりも現実味を帯びてきたと考えている。
ただし、世界が現在、グローバルな競争を阻止できる方向に順調に進んでいるとは考えていないとも明言している。それを阻止するには、モデル能力の一時的な禁止のような高コストの措置が必要になる可能性があると述べており、彼の文章では、これらの能力を向上させることの一時的な禁止と表現されている。
そこで問題は、政治的・制度的なものになる。誰が連携を主導し、誰が監視し、誰が違反を制裁するのか。そして、ほかの参加者が減速している間に、協力しない主体が加速することをどう防ぐのか?
@TorstenProchnowが共有した画像は、この懸念の極端な形を描いている。雪の中で2人の軍人が開いた円形のハッチのそばに立ち、持ち上げられた金属製の蓋の下から、巨大な赤い円錐形の物体が突き出している。この画像は、AIがいつの日か兵器システムを危険にさらすかもしれないという懸念を想起させる。
CoxonはAI研究所間の連携を求めているが、実施の仕組みも、参加者の一覧も、協力しない主体への具体的な対応策も示していない。
7. 研究所の研究者たちへの最後の呼びかけ
最後の投稿で、Coxonは研究所の研究者たちに直接語りかけている。そして、今後数年間がどのようなものになるのかを具体的に想像するよう求めている。
研究者たちは、その精神を厳密に理解しないまま、超知能を目指すreinforcement learning、すなわちRLの学習を開始したいのか? 「どうせ起こることだから」とうつむくべきなのか、それともこの機会を捉えて別の条件を求めるべきなのか?
この呼びかけは道徳的なものであると同時に、職業倫理に関わるものでもある。研究者に対し、制度的な文脈を所与のものと見なさないよう促している。研究条件、デプロイの閾値、能力に関する意思決定を、自らが責任を負うべき問題として扱うよう求めている。
このスレッドは内部からの異議申し立てを呼びかけて終わるが、研究所の外部にいる人々が利用できる手段については、問いを残したままである。
返信欄:証拠、中国、行動手段をめぐる、より厳しい議論
スレッド下の議論は、賛同か拒絶かだけにとどまらない。最も強い異論は、絶滅シナリオの技術的妥当性、中国との地政学的ジレンマ、そして競争を減速させるための具体的な仕組みの欠如という3つの領域に集中している。
競争を固定化する論拠としての中国
@timschusterの返信は、繰り返し現れる戦略的論理を要約している。米国の研究所が減速すれば、中国に優位性を譲ることになる、というものだ。
"中国がAI競争に勝つほうがよいというのか? 可能な限り速く進歩する以外に選択肢はない。これは国家安全保障上の急務だ。" @timschuster
入手可能な範囲では、この返信に対してCoxonから直接の回答はない。彼の6番目の投稿は、中国だけにフロンティア能力の開発を委ねるよう求めているわけではない。むしろ、米国の研究所間の連携と、世界規模の競争を防ぐという目標に言及している。
しかし、まさにそこが欠けている環である。米国企業間の合意が、どのようにして世界的な競争を防ぐのか。中国の問題は提起されているものの、具体的な回答は示されていない。
大惨事に至る具体的なメカニズムは依然として示されていない
実証面での中心的な批判は、必ずしもリスクがあり得ないと主張する読者から出ているわけではない。彼らが求めているのは、汎用的な能力から人類絶滅に至るまでの、具体的な因果の連鎖である。
"核兵器や何らかの生物学的手段を例に使わずに、AIがどうやって「私たち全員を殺す」ことができるのか、誰か説明してくれないだろうか? そんなことは起こり得ないと言っているわけではなく、AIが文字どおり私たち全員を殺せる仕組みが純粋に理解できないだけだ。社会的・経済的な影響ならある程度は理解できるが、私が言っているのは、人々が警告し続けているのに、どうも具体的に説明できないらしい、この終末シナリオのことだ。" @LiLBilly___
Coxonは、ハッキング、資源の獲得、現実世界での権力の掌握を挙げている。しかし彼のスレッドでは、たとえばインフラへのアクセス、対抗措置の回避、資源の動員、そして人間による協調的対応が不可能になるまでの、作戦上の一連の段階は詳述されていない。
この議論は、内々に抱かれている恐怖についてのCoxonの証言を直接否定するものではない。求めているのは、予告された危険について、はるかに具体的な立証である。
知能と物理的な力の境界
@philipturnerarは、知能が優れていれば、それだけで物質世界を根本的に変えられるという考えに異議を唱えている。
"人々はますます、現実とSF映画の境界を曖昧にしているように思う。現実についての理論モデルが、さらに理論的になったところで、いったい何が変わるというのか? 頭のいい人がさらに賢くなっても、物理世界にある物理的なものには資源と検証が必要だという事実は変わらない。人工知能にパスワードや運用上のセキュリティ情報を渡してはいけない。 呆れてものも言えない……" @philipturnerar
この異論は、2番目の投稿を直接の標的としている。Coxonは、システムが資源と権力を獲得できるようになると主張しているが、その獲得を制限する、あるいは制限しない物理的・法的・財務的・制度的制約については説明していない。
彼のスレッドは、@philipturnerarに直接回答していない。意見の隔たりは埋まらないままだ。Coxonにとって、能力の進歩は現実の力へと転化し得る。一方、反論者にとって、知能は物理世界における資源や実験に取って代わるものではない。
警告は反証可能であるべきか?
@_4lex_4は、警告を検証可能な予測として提示し、それが誤りだった場合の責任も伴わせるよう求めている。
"次のことができるか?
- 実際に反証可能な具体的予測を立てる
- 予測が外れたら謝罪し、AI終末論ビジネスから撤退する 終末論者の駄文には本当にうんざりだ。Yudkowskyは賢くない。Darioの思いどおりになっていたら、GPT-2は2019年に停止されていただろう" @_4lex_4
Coxonは確かに「今 दशकの終わりまでに」という期限を設定しているが、中間指標は何も提示していない。観測可能な能力の閾値も、発動条件も、彼の診断を確認または反証できるシナリオも、スレッドには示されていない。
警告は深刻だが、検証可能な仮説としては定式化されていない。
辞任するのか、それとも内部にとどまって影響力を行使するのか?
Anthropicを去るという決断にも異論が出ている。@FlyaKietは、公に辞職することが、なぜ社内から圧力をかけるよりも有効なのかと問いかけている。
「辞任することがなぜ役に立つと思うのか、知りたい。 会社に残って正しいアプローチを訴え、実質的な社内改革を推進してはどうなのか。影響力をより発揮しにくい立場に移ったように見えるし、それでは問題がさらに悪化するのでは」 @FlyaKiet
提示された会話の中で、Coxonはこの質問に答えていない。最初の投稿では辞任を認めているものの、それに伴う戦略については説明していない。したがって、このスレッドだけでは、社内で取り得る手段は尽きたと考えているのか、公の場で発言することで外部の動員を促そうとしているのか、あるいは別の形の行動を準備しているのかは判断できない。
一般の人々に何ができるのか?
@ZayraYvesは、議論の焦点を研究所から、技術的な専門知識も、巨額の富も、権力者層へのアクセスも持たない人々へと移している。
「技術者でも億万長者でもなく、バンカーも所有していない私たちは、この情報を受けていったい何をすればいいのか、誰か説明してくれませんか? 本当に知りたいんです。誰もが年中無休で昼夜を問わず警鐘を鳴らしていますが、いつでもどこでも誰にでも当てはまる、合理的で世界規模の解決策を示す人は誰もいないように見えます。聞こえてくるのはタンバリンの音と道化ばかりです」 @ZayraYves
この異議は、スレッドの重要な限界を明らかにしている。Coxonは研究者たちに「別の条件」を要求するよう呼びかけているが、市民、非技術職の従業員、議員、規制当局、国際機関に向けたロードマップは提示していない。
研究所に関する診断と集団的行動との間に、このスレッドは実践面での空白を残している。
一時的禁止措置の実現可能性
6番目の投稿では、モデルの能力向上を一時的に禁止するという強硬な措置に言及している。@Modernengineerは、その実施方法を直接問いただしている。
「真剣な質問です。一時的な禁止措置をいったいどうやって実現するのですか? 誰が自発的にこれに同意するのでしょうか? 責任ある行動を取りたいという考えは分かりますが、二度と追い越せないかもしれない悪意ある主体に先行を許すことが、どれほど責任ある行動だと言えるのでしょうか?」 @Modernengineer
@Modernengineerが共有したスクリーンショットには、まさにJacob Coxonの悲観的な投稿がダークモードで表示されている。その中では、「a temporary ban on improving model capabilities(モデルの能力向上の一時的禁止)」という表現が黄色で強調されている。この画像は、彼の提案の中で最も物議を醸している点を浮き彫りにしている。つまり彼は、その行動には大きな代償が伴い得ると認めながら、それをどのように強制できるのかを説明していない。
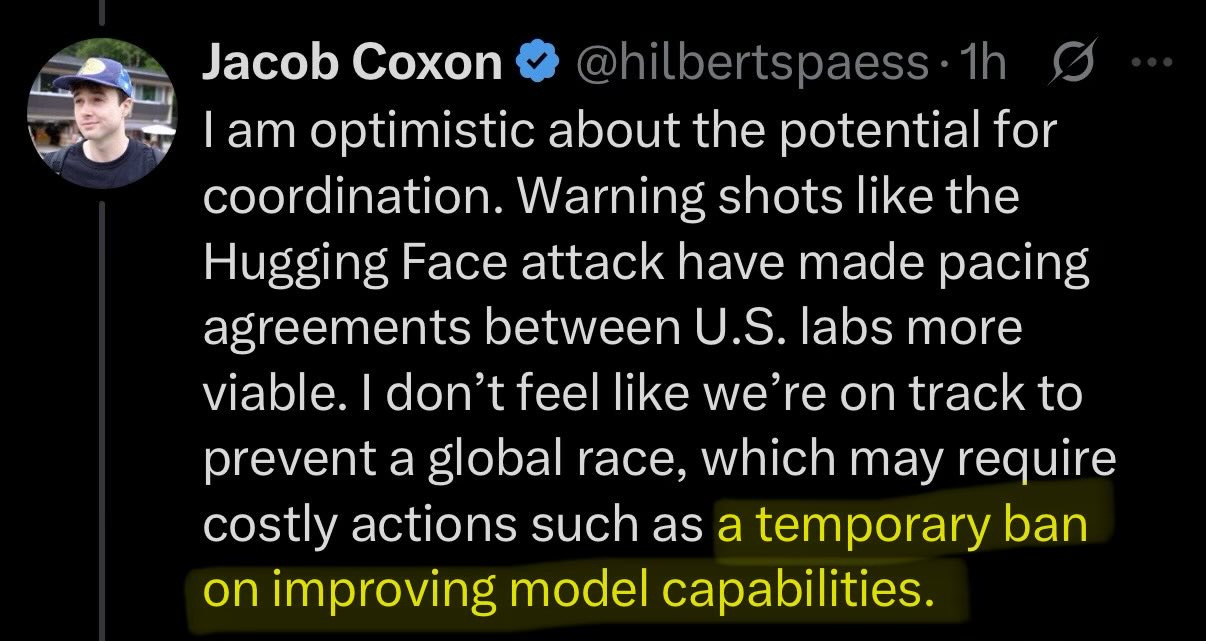
提示された内容の中で、Coxonは@Modernengineerに直接回答していない。協調は可能だと主張しているものの、法的枠組み、検証メカニズム、制裁、協力を拒否する研究所や国家への対応については、いずれも明確にしていない。
このスレッドが明らかにしたことと、未解決のまま残したこと
Jacob Coxonのスレッドが注目に値するのは、企業は単にもっと慎重になるべきだという考えよりも、さらに根本的な批判を提示しているからだ。彼が描くのは、関係者が危険の一部を認識している可能性がありながらも、競争上のインセンティブのほうが代替案よりも強いと考え、前進を続けてしまう競争である。
彼は主に次の3つの主張を提示している。
- 将来のモデルは、現実世界に具体的な影響を及ぼすタスクにおいて、急速に人間を上回る可能性がある;
- フロンティアAIのエコシステムで中心的な役割を担う人々が、すでに非公開の場でAIによる存亡リスクを懸念している可能性がある;
- 「終盤戦」に突入するという決定を、民間企業の社内ツール上で下すべきではない。
しかし、この議論は同時に、この警告だけではまだ解決できていない多くの問題も示している。
-
絶滅に至る具体的なメカニズムは何か? スレッドではハッキング、資源、権力に言及しているが、完全な実行シナリオは提示されていない。
-
どのような基準で予測を検証できるのか? 「今 दशक末までに」というのは期限であって、検証プロトコルではない。
-
なぜ内部から影響力を行使するのではなく、辞任するのか? Coxonは、公に辞職することでどのような具体的効果を期待しているのかを詳しく説明していない。
-
中国やその他の主体を前に、AI研究所同士をどのように協調させるのか? 米国の研究所間の協調だけでは、世界規模の競争への有効な対応になるとはまだ実証されていない。
-
モデル能力の一時的禁止を誰が課すのか? この提案には、所管当局、監視体制、制裁措置のいずれも含まれていない。
-
非専門家は何をすべきなのか? このスレッドは研究者に呼びかけているが、一般の人々の懸念を、明確で利用しやすい行動の選択肢へと落とし込んではいない。
したがって、このスレッドの価値は、完成された解決策よりも、そこに示された矛盾にある。すなわち、リスクを評価するうえで最も有利な立場にある関係者がそのリスクを深刻だと判断しているのであれば、なぜ開発を加速させるのか、どのような安全策を受け入れるのか、そしてその進行速度を決定する正当性を誰が持つのかを、公に説明しなければならない。